PocketPal v1.24.0 本地离线AI助手大模型部署利器 安卓纯净版
面向 Android 平台的本地大模型运行环境,核心机制是在移动端直接执行量化后的开源语言模型,无需依赖云服务器即可生成交互响应。
纯净精简版
支持 Android
站长真机亲测
无弹窗无捆绑
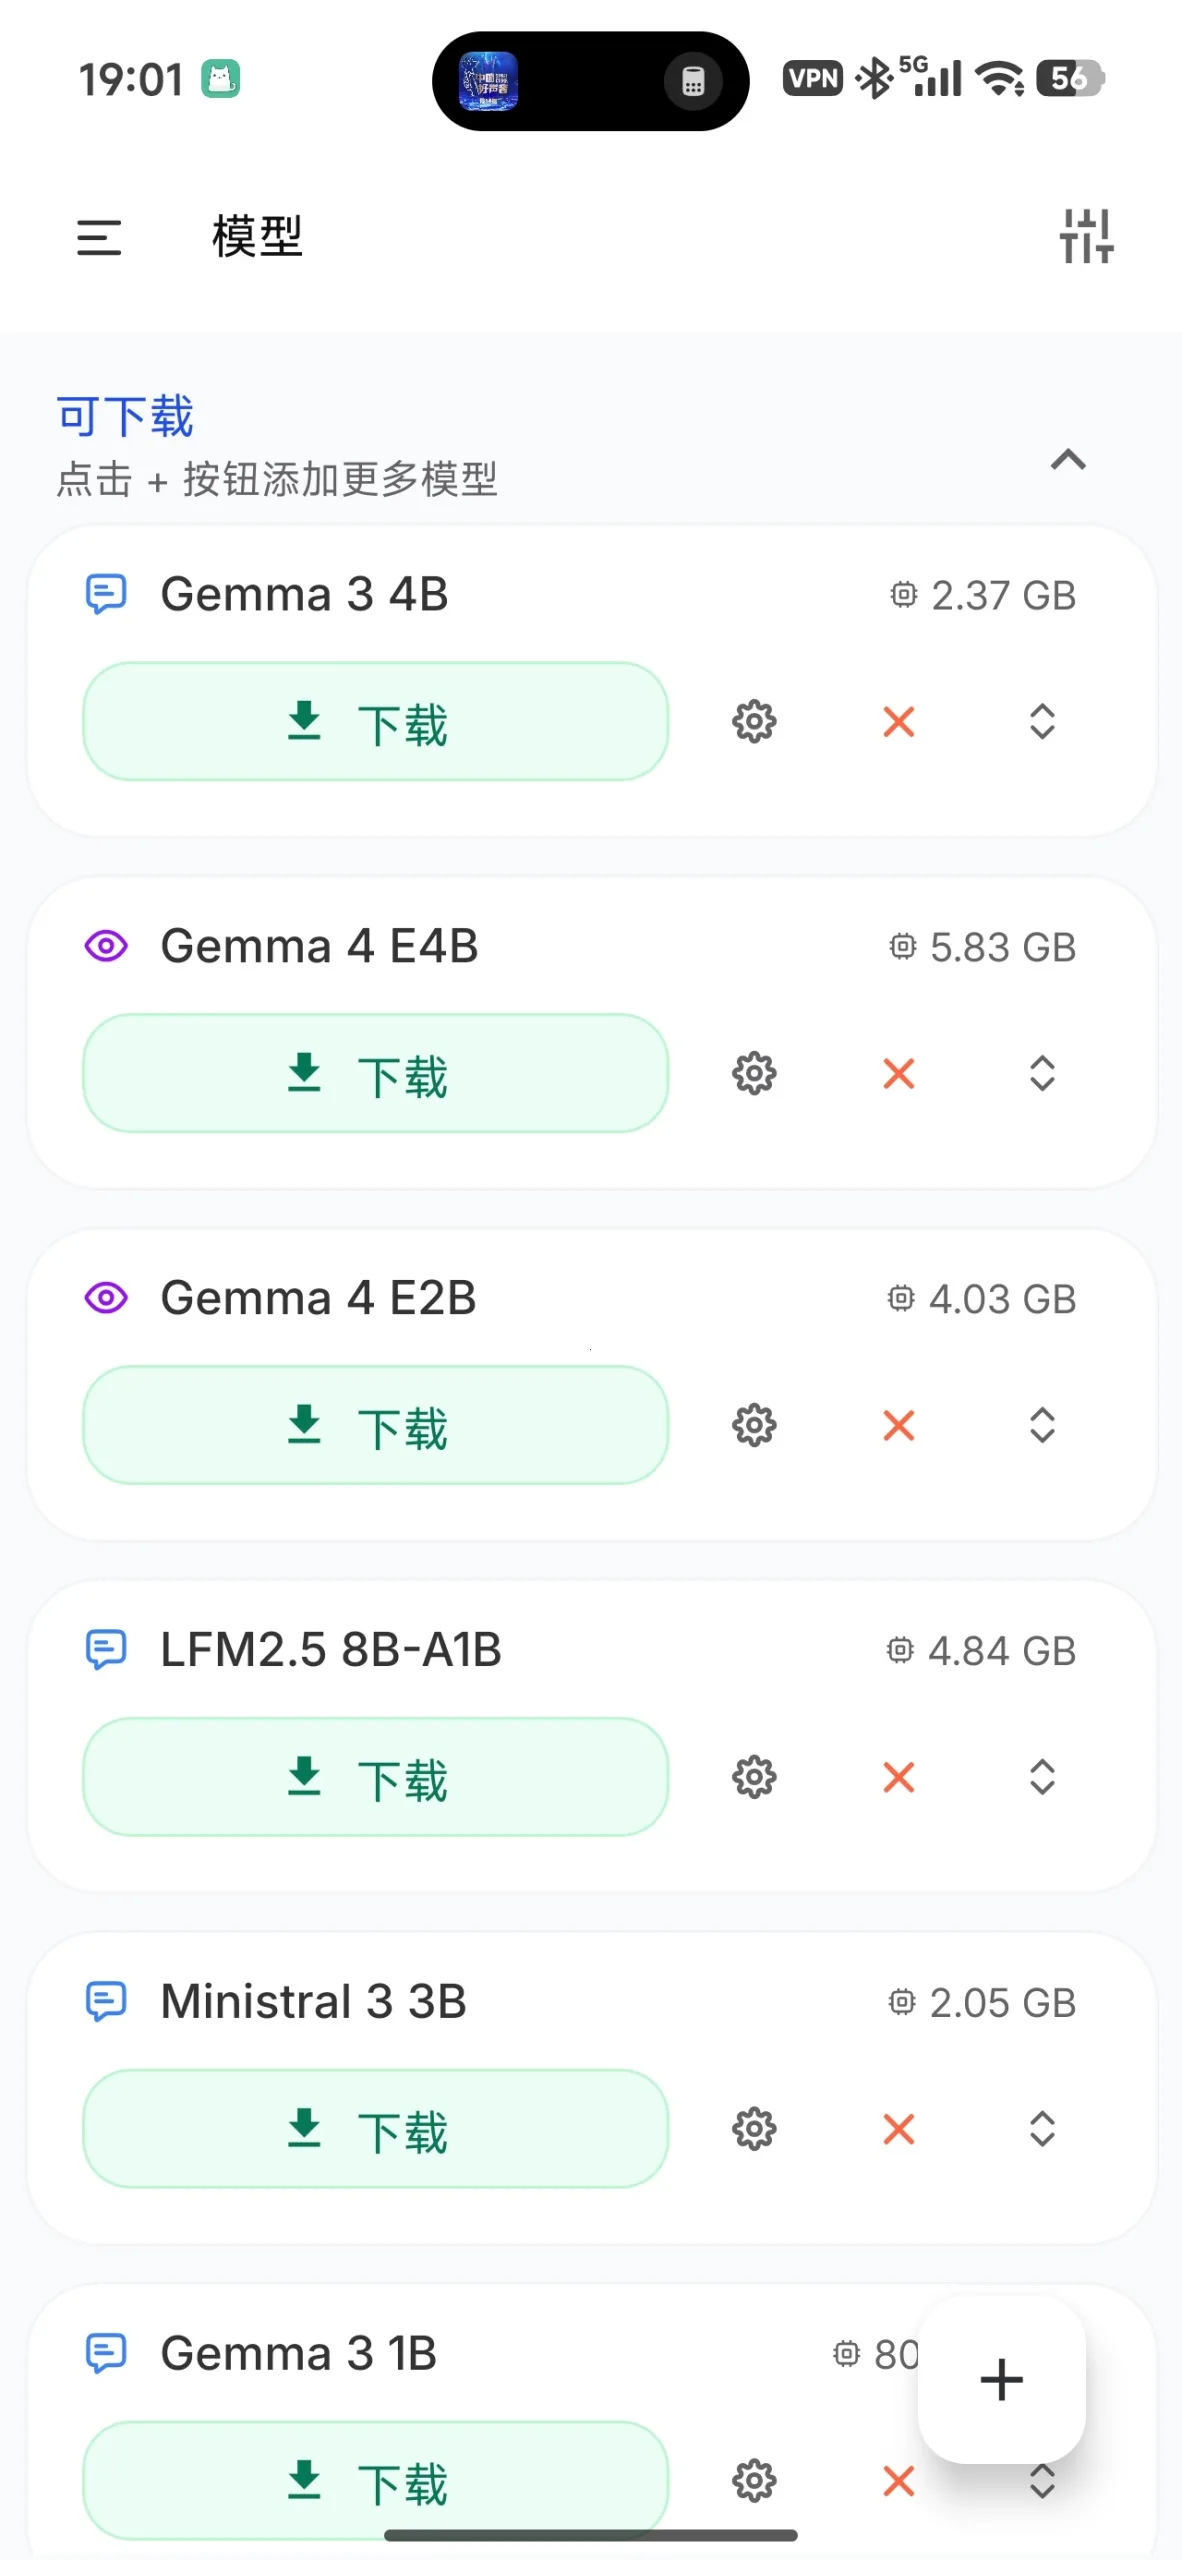
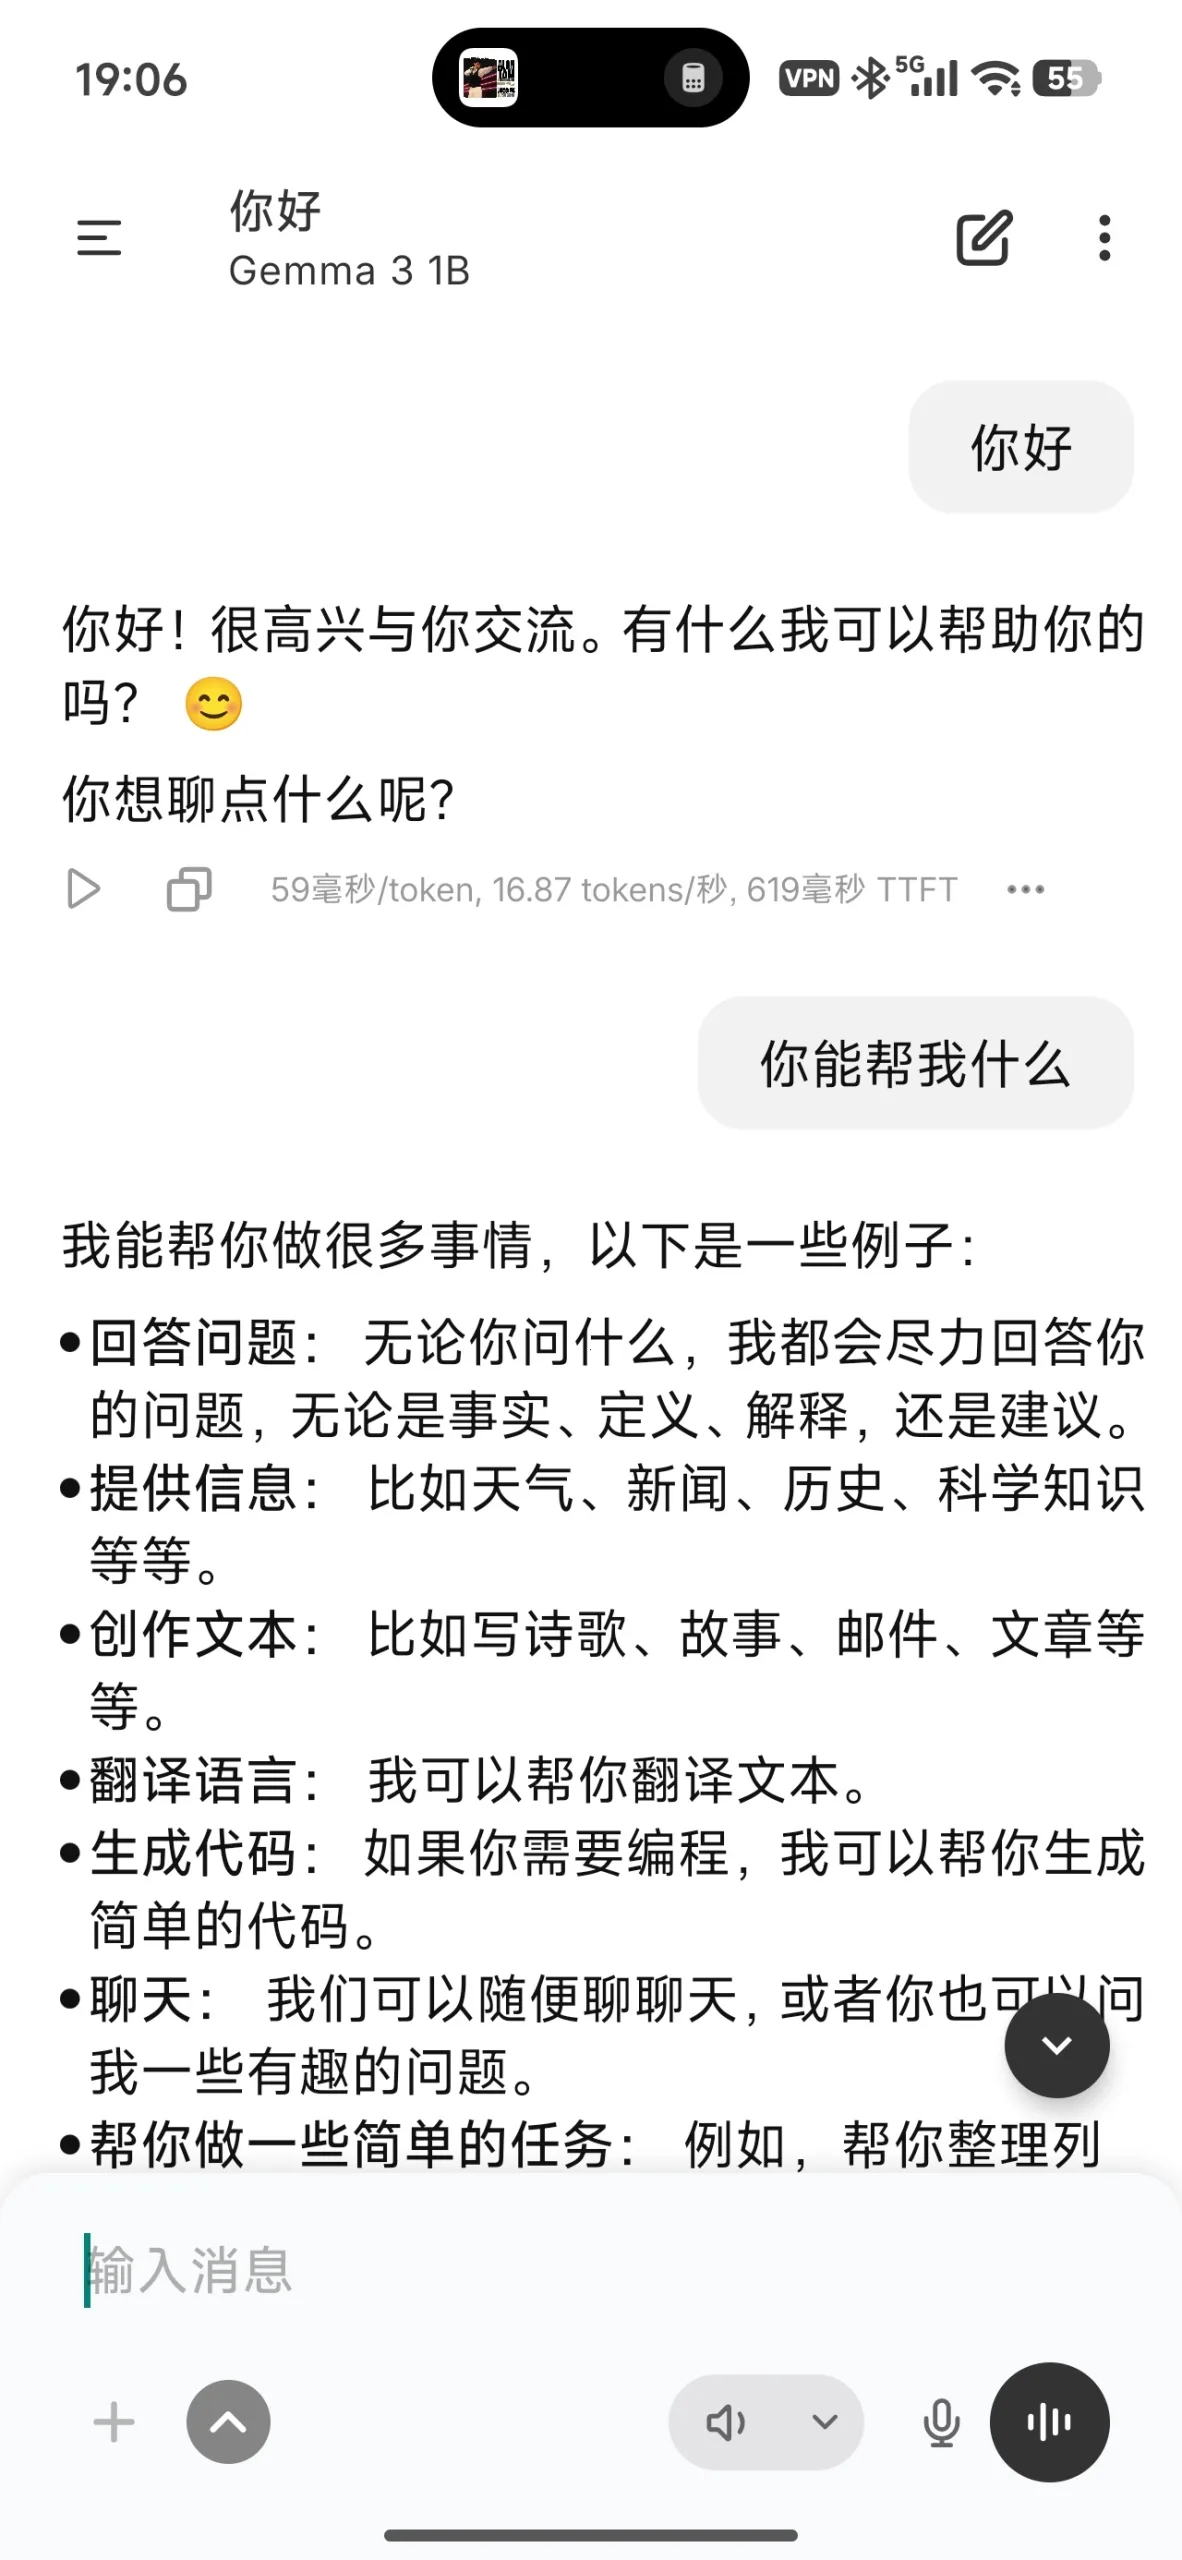
站长真机实测运行截图
真机亲测 · 安装运行正常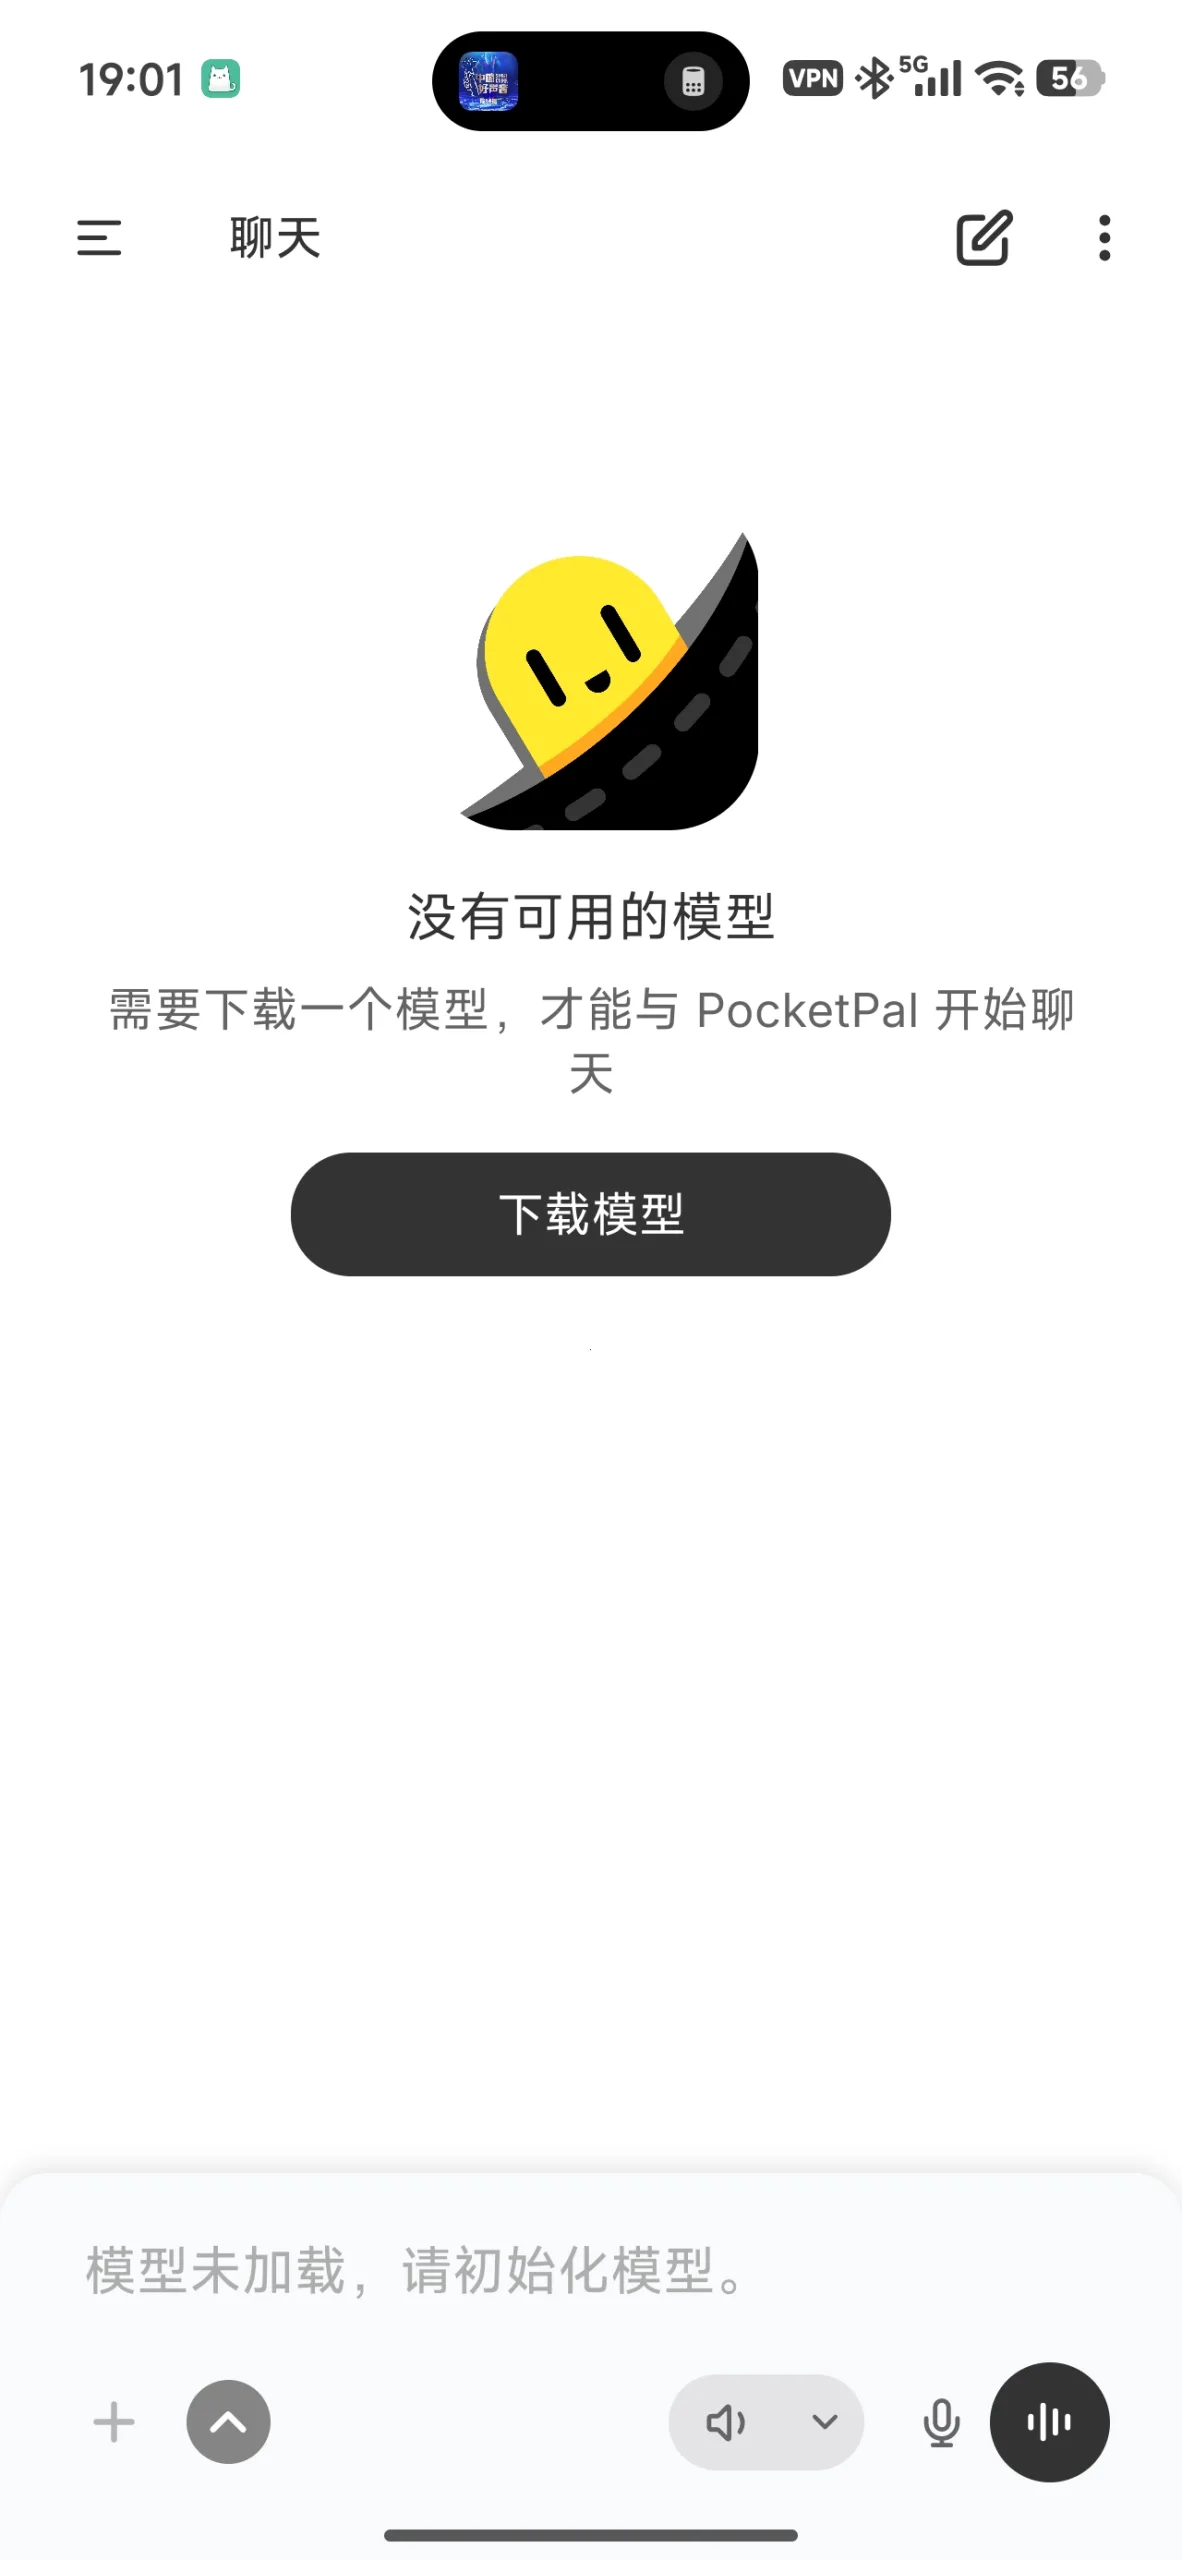
应用介绍
刺客速览 · 核心看点提炼
站长亲测
-
软件定位: 面向 Android 平台的本地大模型运行环境,核心机制是在移动端直接执行量化后的开源语言模型,无需依赖云服务器即可生成交互响应
-
功能亮点: 软件内置 HuggingFace 模型仓库检索入口
-
体验优势: 可直接拉取 DeepSeek-R1、Qwen2、Gemma 等主流开源权重
-
功能亮点: 通过 ONNX Runtime 或 MLC LLM 进行端侧张量运算
PocketPal AI 是一款面向 Android 平台的本地大模型运行环境,核心机制是在移动端直接执行量化后的开源语言模型,无需依赖云服务器即可生成交互响应。软件内置 HuggingFace 模型仓库检索入口,可直接拉取 DeepSeek-R1、Qwen2、Gemma 等主流开源权重,通过 ONNX Runtime 或 MLC LLM 进行端侧张量运算。所有对话文本、系统提示词及模型参数均存储于设备本地文件系统,彻底规避云端数据传输风险。应用本身遵循 AGPL 协议开源,无任何商业化限制,适合对数据主权有严格要求的技术用户。
核心功能介绍
- 本地权重加载执行:支持导入 GGUF、MLC 格式的量化语言模型权重文件,通过在 CPU/GPU 上执行推理引擎完成自回归生成,输出 Token 延迟取决于芯片算力与模型参数量级,典型 7B 量化模型可维持秒级首 Token 响应。;
- HuggingFace 仓库直链:内置 Hub API 检索模块,用户可搜索关键词匹配社区发布的适配移动端的模型变体,支持按参数量、量化精度(Q4KM/Q5KM/FP16)筛选后一键下载至设备存储空间,无需跳转浏览器。;
- 自定义系统提示注入:提供独立配置界面写入持久化 system prompt,替换默认角色定义以改变模型行为输出倾向,支持 JSON 格式保存多组提示模板并在会话间切换使用。;
使用场景说明
适用于需要处理敏感商业文档、医疗病历或个人财务数据的职场人士,以及网络环境受限地区的技术爱好者。科研人员在采集测试集时可用其作为独立推理节点进行批量脚本调用,避免第三方 API 的数据泄露合规风险。
软件优势分析
- 零延迟全离线架构:模型推理全程在 SoC 本地完成,从输入到输出生成不存在网络 RTT 开销,在飞行模式或屏蔽区域仍可正常使用完整对话能力。
- 开源协议透明可控:代码托管于 GitHub 公开仓库,依赖链无闭源 SDK,用户可通过审计确认无遥测上报,数据主权完全掌握在使用者手中。
- 轻量预装生态完整:安装包体积控制在百兆级别,内置基础推理后端无需额外安装编译工具链,开箱即用降低移动端部署门槛。
软件缺点
- 高性能模型受限于设备内存:参数量超过 7B 的模型通常需要 8GB+ RAM 才能流畅运行,低配机型只能加载 1.5B~3B 级别的小尺寸变体导致长上下文生成质量下降。
- 首次获取模型依赖外网:内建 HuggingFace 拉取链路需访问境外 CDN,国内用户在弱网环境下可能出现下载中断或超时失败情况。
常见问题解答
Q:PocketPal 是否支持语音输入和文字转写?
A:当前版本仅处理纯文本交互,未集成 STT/TTS 模块;如需语音控制需配合系统自带听写服务手动操作。
Q:如何切换不同已下载的模型用于对话?
A:在主界面模型管理页可查看已缓存权重列表,点击目标模型卡片进入详情页设置其为当前会话的运行实例。
更新日志
v1.24.0
- 新增 DeepSeek-R1 Distill 系列模型的推理后端适配优化
- 修复部分搭载高通 Gen3 芯片设备在连续对话场景下的显存释放异常
总结
PocketPal AI 填补了移动端私有化大模型运行的空白,将原本需要服务器集群支撑的 LLM 推理任务下沉至消费级芯片。对于注重隐私边界与技术掌控力的用户而言,它提供了一种真正属于自己的本地智能助手方案,而非受制于云厂商数据政策的黑盒服务。
© 软件著作权归原作者所有。本站所有资源均来源于网络,仅供个人技术研究与学习交流使用,请支持正版软件。