PocketPal 手机本地离线运行开源大模型与GGUF参数微调工具 开源版
基于开源架构打造的安卓端侧本地AI大模型运行与管理工具,软件全面支持在手机本地直接加载与推理各类GGUF量化模型,断网离线即可展开智能问答对话。
开源免费
支持 Android
站长真机亲测
无弹窗无捆绑
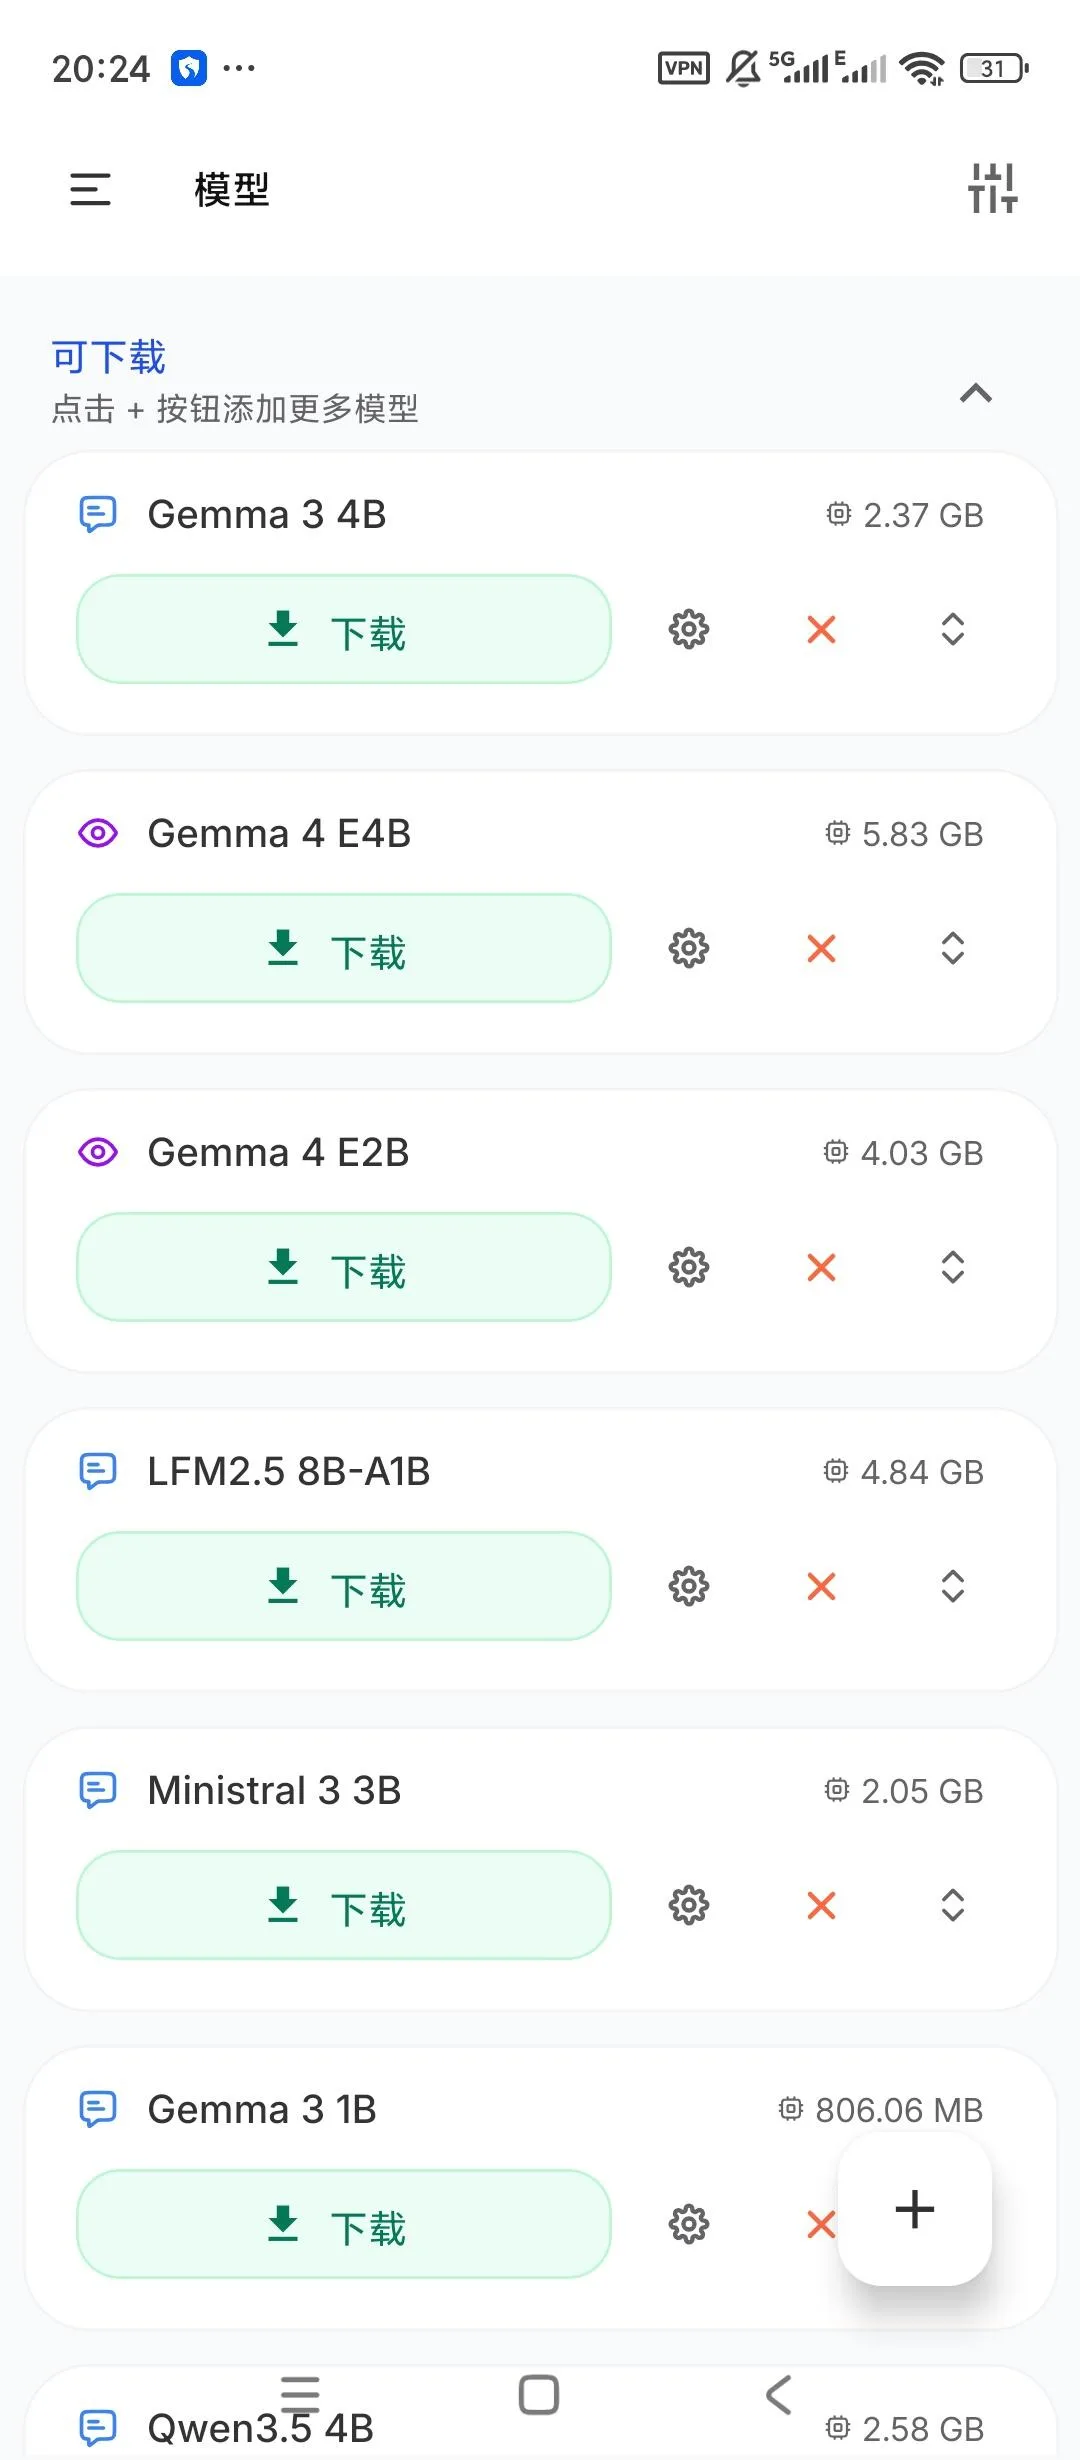
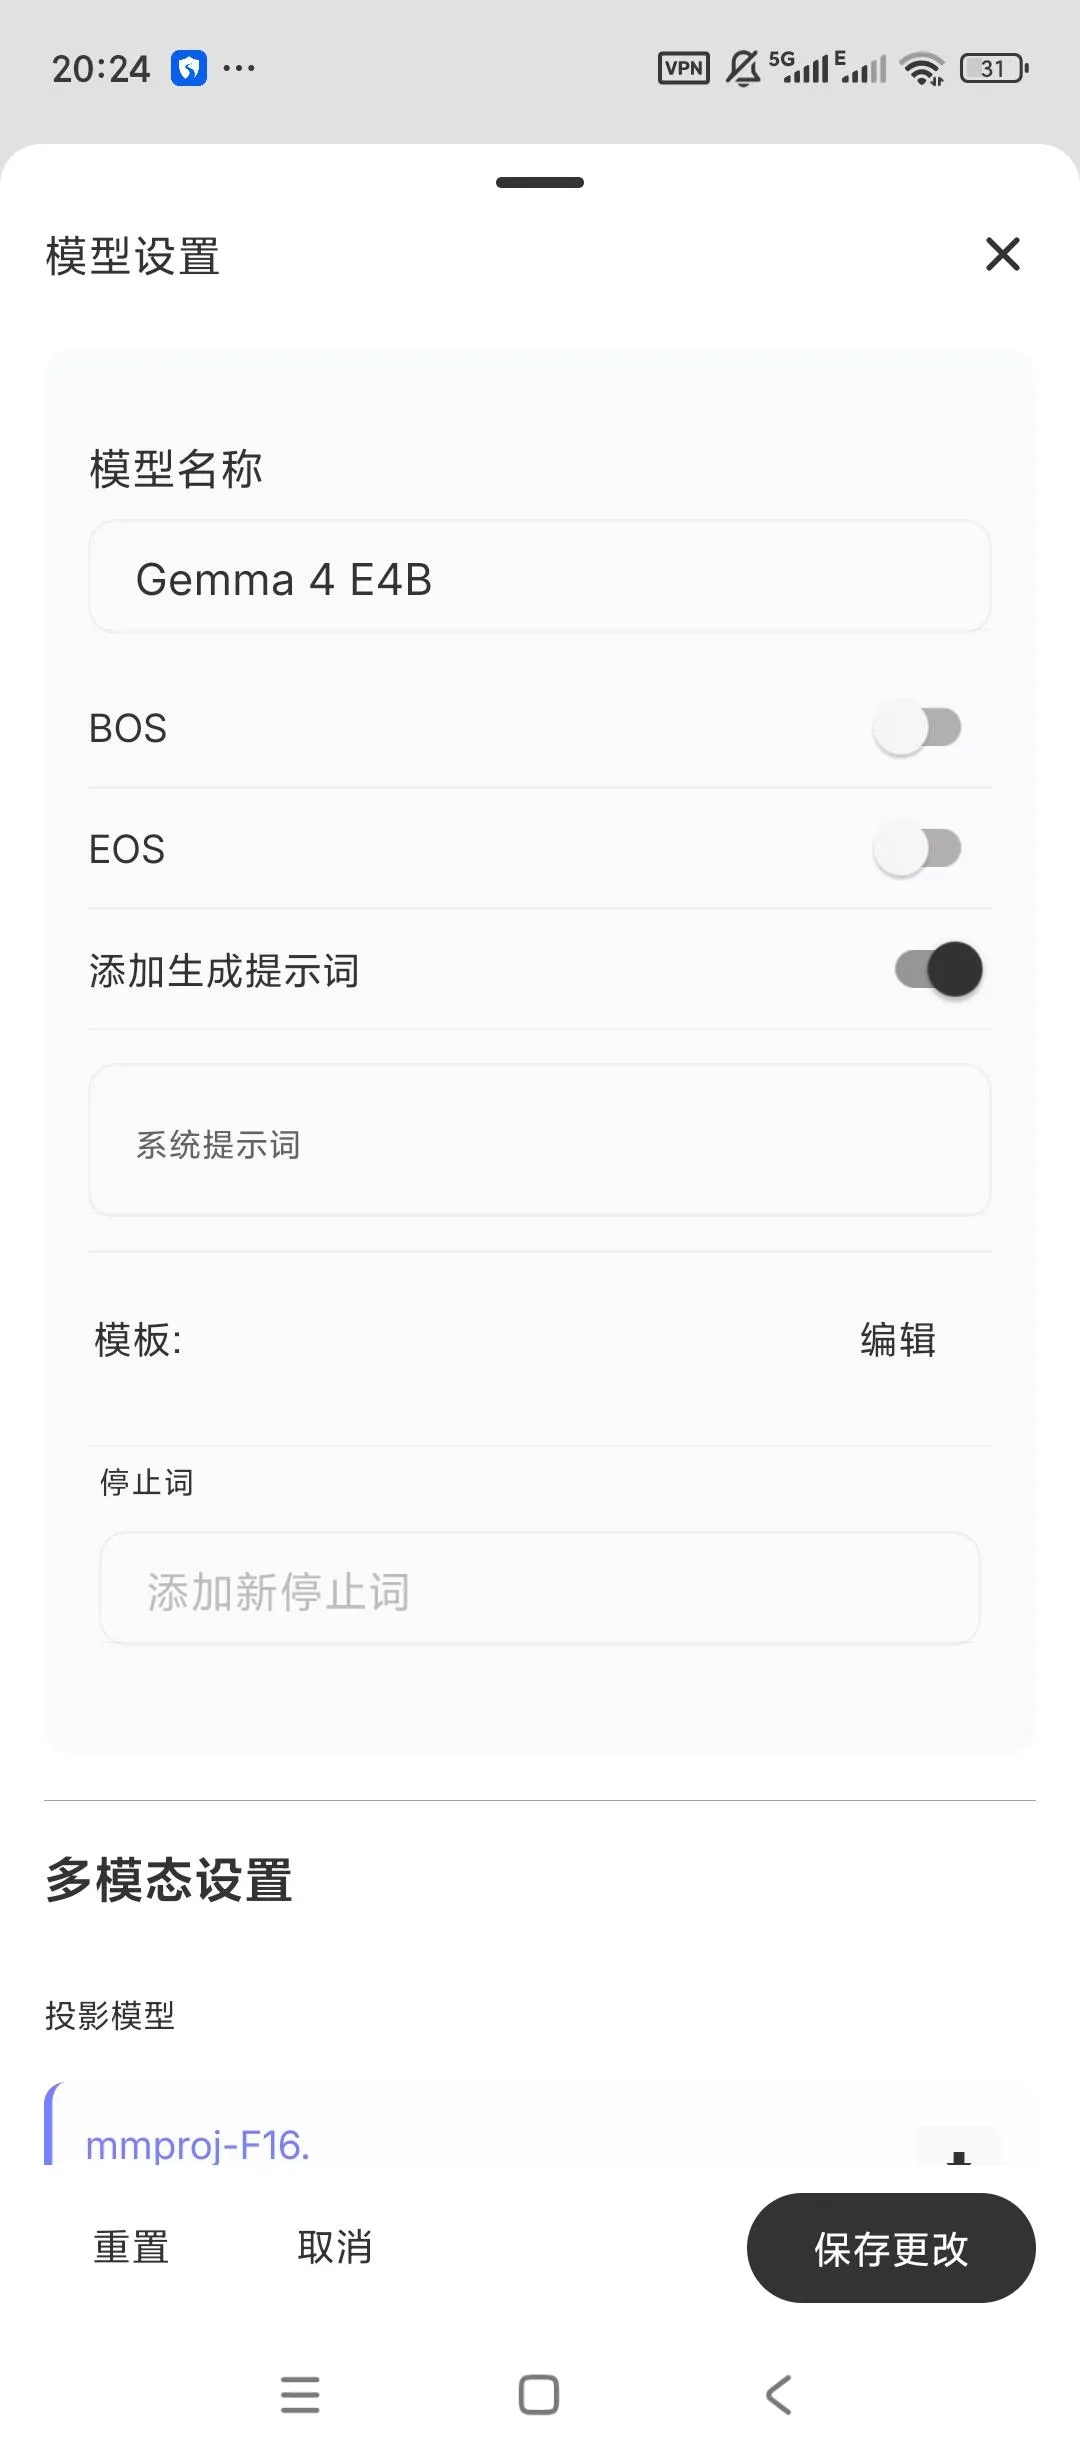
站长真机实测运行截图
真机亲测 · 安装运行正常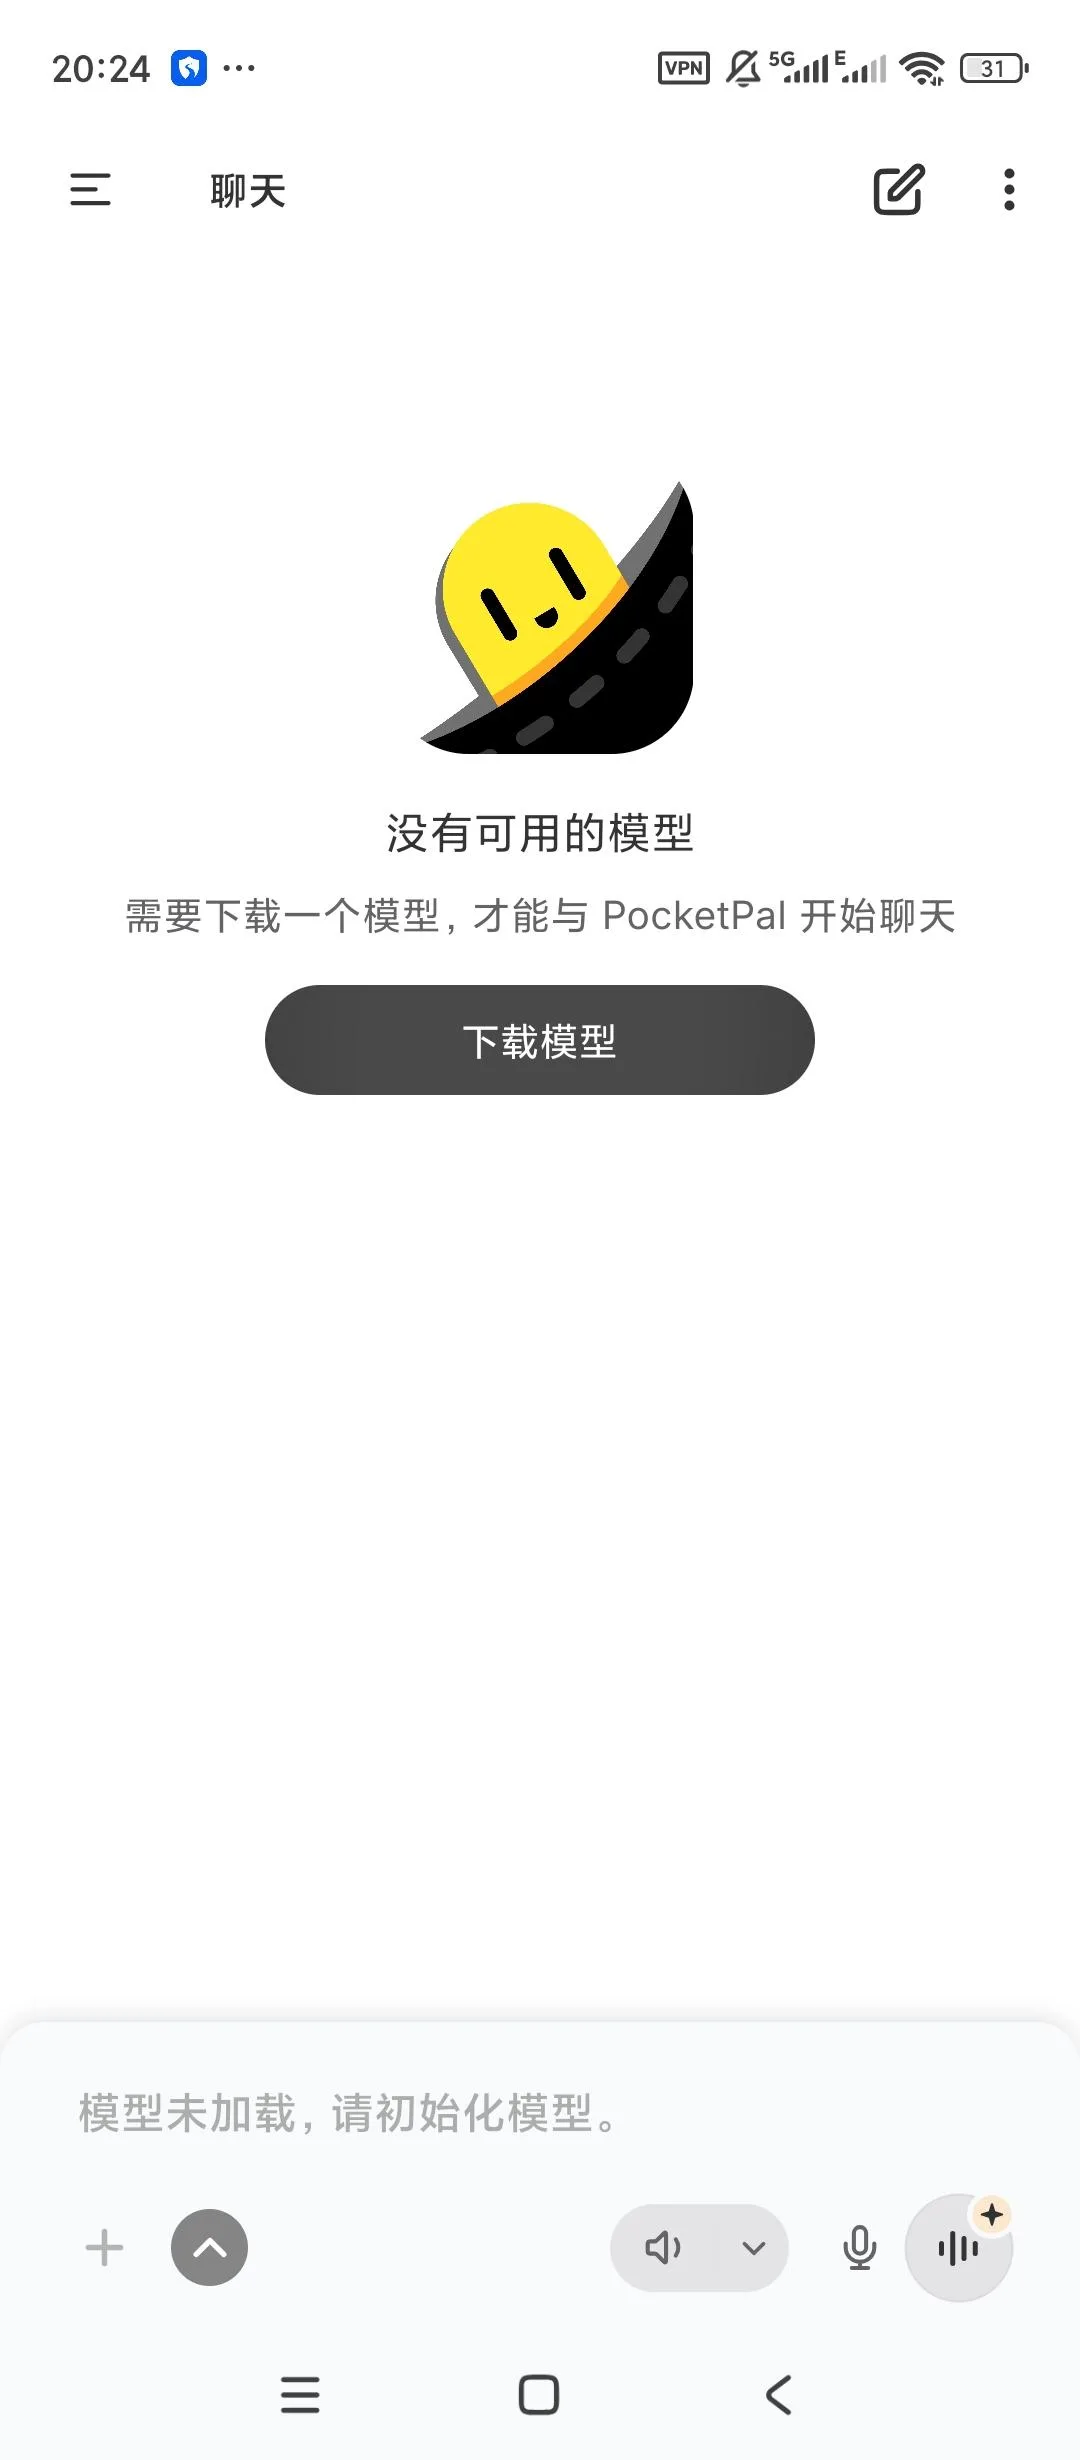
应用介绍
刺客速览 · 核心看点提炼
站长亲测
-
软件定位: 基于开源架构打造的安卓端侧本地AI大模型运行与管理工具
-
功能亮点: 软件全面支持在手机本地直接加载与推理各类GGUF量化模型
-
功能亮点: 断网离线即可展开智能问答对话
-
功能亮点: 提供丰富的模型温度、上下文长度与硬件GPU加速调度微调选项
在手机上完全离线运行开源大模型的专业工具,隐私安全自主可控。
核心功能介绍
- 纯本地端侧离线运行:下载模型后无需网络即可实时智能对话问答;
- 广泛兼容GGUF模型:支持Llama、Qwen、Phi等各类主流开源模型加载;
- 深度生成参数调节:支持温度、上下文长度、Top-P及重复惩罚微调;
- 自定义系统提示词:内置专属角色模板,支持自定义提示词与停止词;
- 硬件GPU加速调度:调用Vulkan/OpenCL移动加速引擎,优化内存占用。
使用场景说明
100%端侧离线推理;兼容主流GGUF生态;移动GPU硬件级加速;隐私数据零泄露
软件优势分析
- 彻底摆脱对云端服务器依赖,即使飞行模式下也能顺畅交流;
- 完全开源无商业推广,绝不上传用户任何个人聊天隐私;
- 针对不同安卓 SoC 进行了 GPU 加速适配,每秒吐字速度优异;
- 支持从 Hugging Face 直接搜索下载模型,免去复杂的电脑中转传输。
软件缺点
常见问题解答
Q:我的手机应该选择多大参数的模型运行?
A:6GB~8GB 运存手机建议选择 1B~3B 参数的 Q4 量化模型(如 Qwen2.5-1.5B/3B、Llama-3.2-3B);12GB 及以上旗舰机型可流畅运行 7B/8B 规格模型。
Q:下载模型时提示连接失败怎么处理?
A:由于 Hugging Face 属于海外模型源,如直接下载速度慢,可通过电脑下载好对应的 .gguf 模型文件后传入手机本地存储,在软件内直接浏览导入。
更新日志
v1.22.0
- 升级底层 llama.cpp 推理内核,显著提升模型加载与首字生成响应速率;
- 优化多模态视觉小模型(SmolVLM 等)的图片理解解析兼容性;
- 增强针对高通 Adreno 与天玑 Mali GPU 的 OpenCL/Vulkan 加速稳定性;
- 完善模型管理面板的断点续传队列与存储空间预警提示;
- 修复低内存设备在长文本上下文持续生成时偶现的闪退问题。
总结
想在手机上不联网体验最新开源 AI 大模型?PocketPal 是一款开源强大的移动端本地大模型运行与推理工具。支持直接载入 Qwen、Llama 等主流 GGUF 模型,依托端侧 GPU 硬件加速,支持参数自定义与角色人设构建,全程 100% 本地离线运行,开启完全私密的口袋 AI 时代。
© 软件著作权归作者所有。本站所有软件均来源于网络,仅供学习使用,请支持正版。