批量转双层PDF 扫描件OCR识别文字层生成与国网标书OFD格式转换工具 绿色版
专为档案数字化与招投标标书制作打造的高效本地OCR文档处理工具,软件支持将扫描版PDF、JPG图片及Word文档批量转换为双层可检索PDF,并可选导出OFD格式。
官方原版纯净
绿色免安装便携版
站长真机亲测
无弹窗无捆绑
站长真机实测运行截图
真机亲测 · 安装运行正常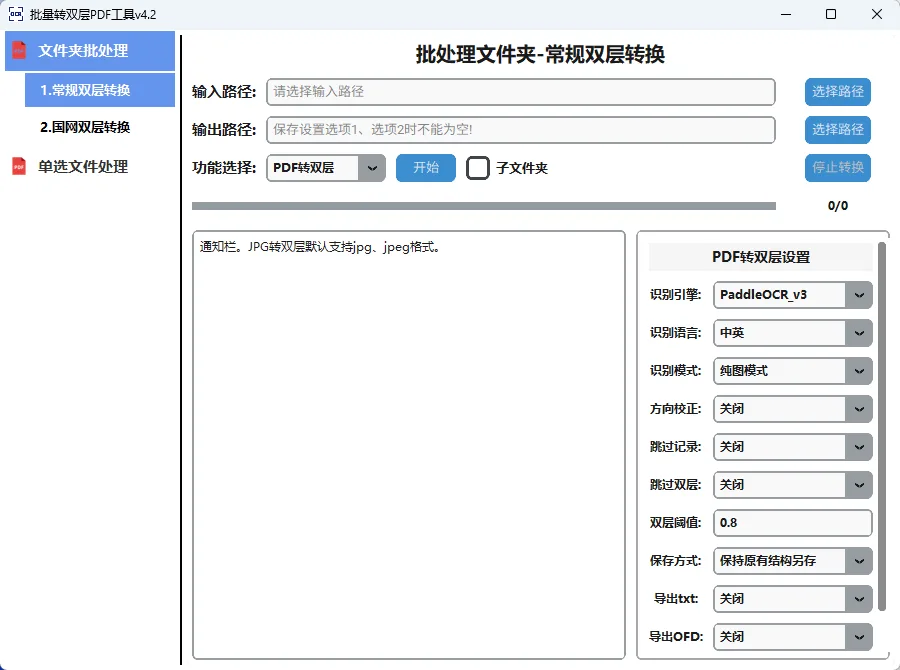
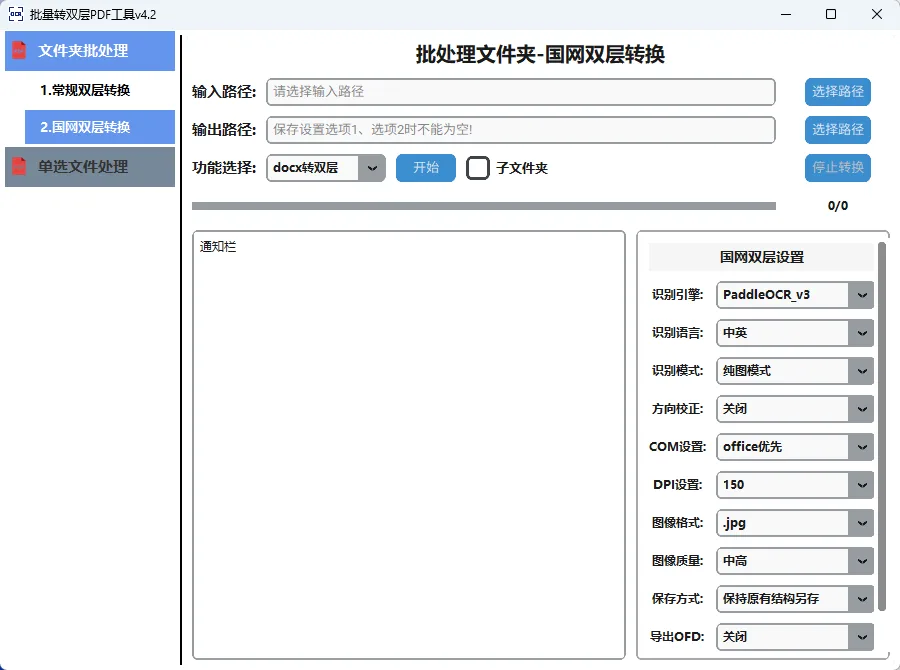
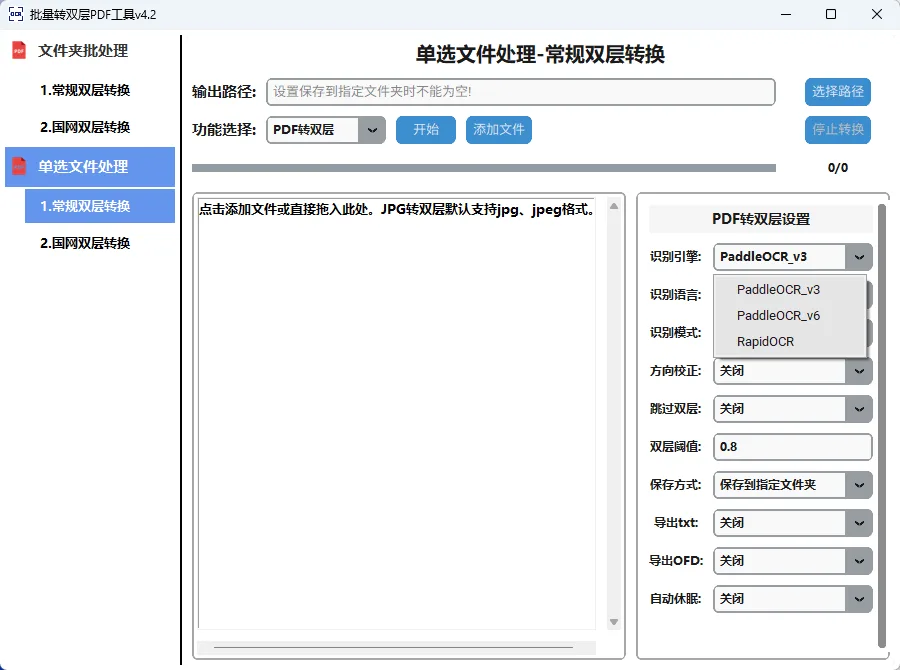
应用介绍
刺客速览 · 核心看点提炼
站长亲测
-
软件定位: 专为档案数字化与招投标标书制作打造的高效本地OCR文档处理工具
-
核心功能: 软件支持将扫描版PDF、JPG图片及Word文档批量转换为双层可检索PDF
-
功能亮点: 并可选导出OFD格式
-
功能亮点: 内置PaddleOCR与RapidOCR多离线引擎
招投标标书与档案数字化必备的高效OCR工具,离线批量生成双层PDF与OFD。
核心功能介绍
- 多格式批量转双层PDF:原生支持PDF、JPG/JPEG、Word(doc/docx/wps)等文件批量处理;
- 完备离线OCR识别引擎:内置PaddleOCR(v3/v6)与RapidOCR内核,全程本地离线运行免除泄密风险;
- 多语言与方向自动纠偏:支持中英、繁体中文、日文、韩文及俄文等语种识别,纯图模式支持角度校正;
- 国家标准OFD格式支持:支持一键导出符合国网及企事业单位标准的OFD电子凭证文档;
- 命令行与API深度集成:配套提供轻量易用的Python开发接口与CLI命令行工具,便于自动化流水线对接。
使用场景说明
多格式批量快速转换;多离线OCR引擎支持;方向自动纠偏;可导出国标OFD格式
软件优势分析
- 全程离线运行,严密保障投标文件、商业合同及涉密档案的数据安全;
- 识别精度高且版面还原准确,生成的双层PDF文字层与底层图像精准对齐;
- 兼具直观图形交互界面与强大命令行/Python API,满足普通办公与极客自动化;
- 免安装绿色便携架构,解压即用,不依赖复杂外部 Python 环境。
软件缺点
常见问题解答
Q:什么是双层 PDF?
A:它和普通 PDF 有什么区别?
Q:A: 双层 PDF 包含两层内容:上层是保持原始扫描件清晰原貌的图像层,下层是通过 OCR 识别精准对齐的透明文字层。用户在阅读时能看到最真实的纸质原貌,同时可以直接选中、复制文字或进行全文快速搜索检索。
Q:制作转换过程需要联网吗?
?
A:完全不需要。本软件所有 OCR 模型与渲染库均内置打包在本地,无需联网即可离线运行,严防数据泄露。
更新日志
v4.2
- 优化 PaddleOCR 与 RapidOCR 底层推理流水线,提升大批量 PDF 转换速度;
- 完善 OFD 导出模块的排版兼容性,确保符合最新国家标准版式规范;
- 增强命令行 CLI 与 Python API 接口,新增页级转换进度实时回调与 JSON 汇总;
- 改进纯图模式下对倒置与倾斜页面的文字方向自动纠偏算法;
- 修复特定包含复杂特殊字符路径下临时文件读写偶发权限冲突的问题。
总结
遇到招投标标书强制要求双层可搜索 PDF 或档案扫描件无法复制检索?批量转双层PDF 是一款专注于高效文档数字化的本地离线转换工具。支持 PDF、JPG 及 Word 格式批量转换为包含图像与可搜索文本的双层 PDF,可选导出 OFD 标准格式。内置 PaddleOCR 与 RapidOCR 识别内核,支持方向自动纠偏与多语言识别,数据全程本地处理,安全可靠。
© 软件著作权归作者所有。本站所有软件均来源于网络,仅供学习使用,请支持正版。